Jak funguje AI? Hádá ChatGPT jen další slovo, nebo už přemýšlí
ChatGPT každý týden používá skoro miliarda lidí. Málokdo ale ví, co se v něm doopravdy děje. Často se říká, že AI jen hádá další slovo. Jedni tvrdí, že přesně tak to je. Druzí, že je to dávno jinde.
V novém dílu TradeCZ Hub jsme to prošli od úplného začátku. A protože jsme investiční kanál, podívali jsme se i na to, na čem to celé běží a kdo na tom zatím vydělává.
Kdo na AI vydělává?
Co je neuronová síť
Jeden umělý neuron není nic tajemného. Je to malý kousek matematiky. Dostane pár čísel, každé vynásobí vlastní váhou, výsledky sečte a podle součtu pošle dál jedno číslo.
Příklad: máte si ráno vzít deštník? Neuron dostane tři čísla: jak moc je zataženo, co hlásí předpověď a jestli pršelo včera. Předpověď má velkou váhu, včerejší déšť malou.
Když součet přeleze určitou hranici, neuron řekne: deštník ano.
Váhy jsou parametry, čísla, která rozhodují, co je důležité.
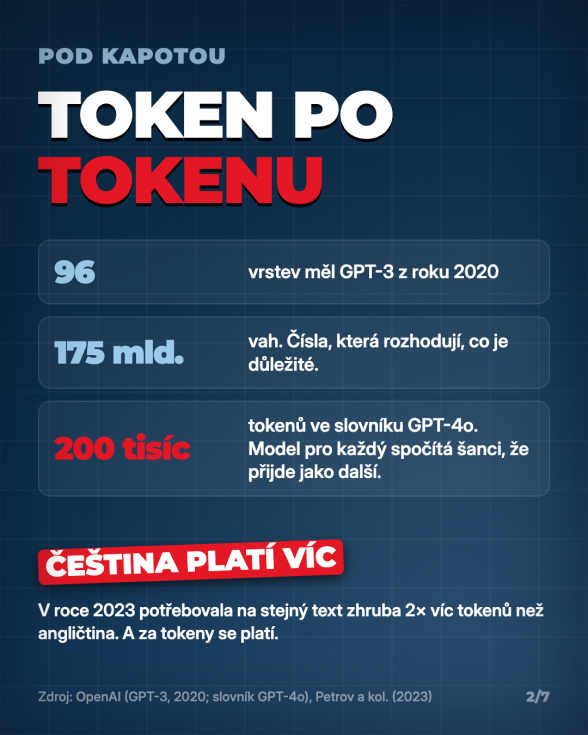
Jeden neuron toho moc neumí. Tisíce neuronů vedle sebe ale tvoří vrstvu a vrstvy se skládají za sebe. GPT-3 z roku 2020 měl 96 vrstev a dohromady 175 miliard vah.
Jak se síť učí
Váhy nikdo neprogramuje. Na začátku jsou náhodné. Síť si tipne, tip se porovná se správnou odpovědí a každá váha se o kousek posune tak, aby chyba klesla. Pak další várka příkladů, u velkých modelů celé měsíce.
Postupu se říká zpětné šíření chyby a v roce 1986 ho proslavil i Geoffrey Hinton, pozdější nositel Nobelovy ceny za fyziku.
Proč to potřebuje tolik čipů? Trénink GPT-4 vyžadoval podle odhadu Epoch AI zhruba 21 milionů miliard miliard operací. Jeden počítač s bilionem operací za sekundu by na tom pracoval přes 600 tisíc let. Proto se trénuje na desetitisících čipů najednou, hlavně od Nvidie.

Jak model čte text
Každá otázka se nejdřív rozseká na kousky, kterým se říká tokeny. Token je často celé krátké slovo, jindy jen jeho část nebo čárka. GPT-4o má ve slovníku zhruba 200 tisíc takových kousků.
Zajímavost pro nás: podle výzkumu z roku 2023 potřebovala čeština na stejný text zhruba dvakrát víc tokenů než angličtina. A za tokeny se platí. U novějších modelů je rozdíl menší, ale pořád tam je.
Každý token se pak převede na dlouhou řadu čísel, něco jako souřadnice na mapě. U GPT-3 to bylo 12 288 čísel. Slova s podobným významem leží blízko sebe. Českou stopu tu má Tomáš Mikolov: v roce 2013 s kolegy ukázal, že král minus muž plus žena vyjde nejblíž slovu královna.
Samotné slovo ale nestačí. Odemkl zámek, navštívil zámek: stejné slovo, jiný význam. Proto v roce 2017 přišli vědci z Googlu s transformerem, to je to T v názvu ChatGPT. Jeho základem je pozornost: každý token se podívá na tokeny před sebou a podle těch důležitých si upraví svoje čísla.
Na konci model spočítá pro každý token ve slovníku šanci, že přijde jako další, a jeden vybere, trochu jako losem. Takže ano, jazykový model pořád odhaduje, co přijde dál. Změnilo se ale, jak se to učí.
Jak se AI učí dnes
Učení velkého modelu má dnes tři fáze. V první projde obrovské množství textu: internet, knihy, články, kód. Vznikne základní model, který umí doplňovat text, ale ještě neumí pořádně odpovídat.
Ve druhé se učí od lidí. V roce 2022 dalo OpenAI hodnotitelům porovnat malý model s 1,3 miliardy parametrů, který tímhle učením prošel, a GPT-3 se 175 miliardami bez něj. Víc se jim líbil ten přes stokrát menší.
Třetí fáze je opravdu nová, ve velkém zhruba od roku 2024: učení pokusem a omylem na úlohách, kde jde výsledek ověřit automaticky. Čínský DeepSeek takhle učil model R1-Zero a jeho úspěšnost v matematické soutěži AIME vyskočila z 16 % na 78 %.
Co je opravdu nového: přemýšlení a agenti
Dnešní modely umí takzvaně přemýšlet. Ne jako člověk. Než odpoví, napíšou si poznámky, zase token po tokenu, a bývají to stovky až desítky tisíc tokenů. Vy je většinou nevidíte, ale někdo je zaplatit musí.
V testu logických hádanek ARC-AGI-2 měl GPT-4o v roce 2024 0 %. Dnešní GPT-6 Astra od OpenAI má bez přemýšlení 60 % a s přemýšlením naplno 95 %. Stejný model, jedna úloha ale stojí třikrát víc. Víc přemýšlení znamená víc výpočtů a víc výpočtů víc čipů.
Druhá novinka jsou nástroje a agenti. Model si sám spustí vyhledávání, otevře zprávu, vytáhne čísla a teprve potom odpoví.
V testu OSWorld, kde AI sama ovládá počítač, zvládli studenti informatiky v roce 2024 72 % úloh.
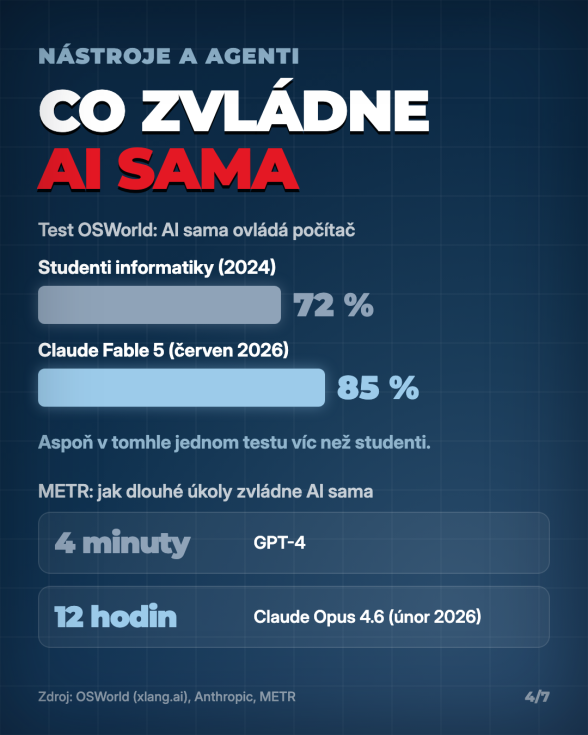
Claude Fable 5 od Anthropicu z letošního června kolem 85 %, aspoň v tomhle jednom testu tedy víc než studenti.
Podle organizace METR zvládal GPT-4 sám úkoly, které zkušenému člověku trvají 4 minuty. Claude Opus 4.6 letos v únoru už zhruba 12 hodin, hlavně v programování. U tak dlouhých úkolů je ale měření hodně nejisté.
Ale pozor na halucinace
AI není neomylná. Když o něčem viděla málo textů, pořád vyrobí odpověď, která zní věrohodně. Tomu se říká halucinace. GPT-5 s přemýšlením měl podle OpenAI aspoň jednu závažnou faktickou chybu ve 4,8 % odpovědí na skutečné dotazy, starší GPT-4o skoro ve 21 %.
Soudy už ale vydaly přes 2 200 rozhodnutí, ve kterých řešily výmysly z AI. Kontrolujte zdroje, hlavně u čísel o penězích.
Na čem to běží: čipy, paměti, elektřina
Velké AI datacentrum stojí podle šéfa Nvidie zhruba 50 až 60 miliard dolarů na každý gigawatt příkonu a asi 35 miliard z toho skončí u Nvidie. Ta měla za poslední čtvrtletí tržby 96 miliard dolarů, z toho 89 miliard z datacenter, a hrubou marži 75 %.
Čipy ale jen navrhuje. Vyrábí je tchajwanská TSMC na strojích od nizozemské ASML.
Pak jsou tu paměti, o kterých se moc nemluví. Micron měl za poslední čtvrtletí tržby 54 miliard dolarů, rok předtím 11, a hrubou marži skoro 87 %, víc než Nvidia.
Před rokem přitom měl kolem 45 %.
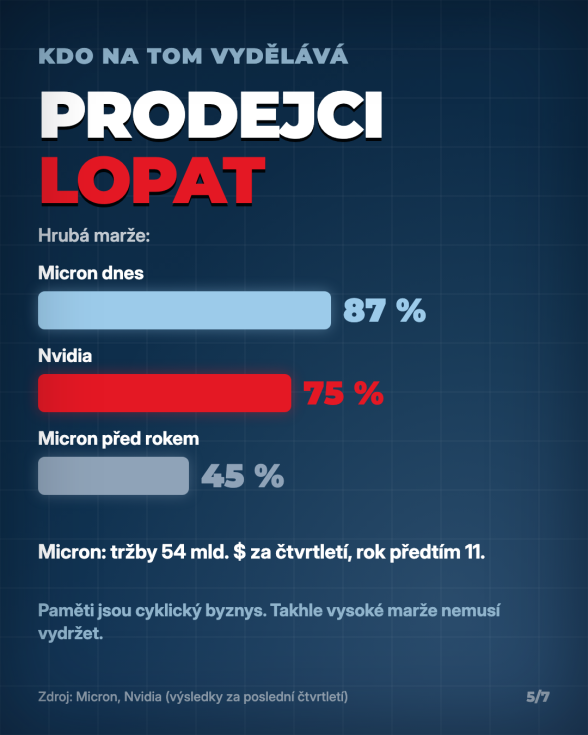
Paměti jsou ale cyklický byznys a takhle vysoké marže nemusí vydržet.
A elektřina. Typický dotaz v Gemini spotřebuje podle Googlu 0,24 watthodiny, při dlouhém přemýšlení podle výzkumníků Microsoftu i kolem 4.
Všechna datacentra světa loni spotřebovala podle Mezinárodní energetické agentury 485 terawatthodin, 7 až 8krát víc než celé Česko za rok.
TIP: Oblíbená investiční aplikace XTB